競馬の予測において、単勝オッズが持つ情報量は非常に強力です。以前の記事で示した通り、確定オッズの疑似R²は約0.21に達し、市場参加者全員の知恵を集めた数字はそれだけで強力な予測器になります。
ではファンダメンタルズ情報、つまりオッズを一切使わずに馬・騎手・調教師・過去成績のデータだけで、どこまで確定オッズの情報量に迫れるのか。
今回はそれを機械学習で実験した途中経過を報告します。
(※コードの実装はClaudeに大部分を投げていますが、設計方針・特徴量選定・結果の解釈は自分で行っています。)
1. フレームワーク
モデルの出力を確率に変換する方法として、soft-max関数を採用しました。レース内の全馬に対してモデルがスコアを出力し、それをsoft-maxで正規化することで勝率に相当する確率を得ます。
これは多項ロジットモデルと同じ構造で、Benterが競馬予測に採用した枠組みそのものです。
評価指標は以前と同様のBenter流疑似R²を使います。
ここで L(Θ^) はモデルの対数尤度、L(Θ=0) は全頭均等確率(1/N)のベースライン対数尤度です。
学習アルゴリズムにはLightGBMのlambdarankを採用しました。lambdarankはレース内の馬同士の順位関係を直接最適化するランキング損失で、ソフトマックスによる確率変換との相性が良いです。
教師ラベルは1着に4、2着に2、3着に1、それ以外に0を割り当てています。1着を特別に重視した非線形な重み付けです。
2. データ
TARGETから取得した2018〜2025年のJRA全レースデータを使用しています。
| 区分 |
年度 |
用途 |
| バッファ |
2018〜2019 |
前走特徴量の計算に使用、学習には含めない |
| 学習 |
2020〜2023 |
約11,900レース |
| 検証 |
2024 |
約2,977レース |
| テスト |
2025 |
(未使用) |
なお、異常コード(取消・失格等)が含まれるレースはまるごと除外しています。また、データが1着順に並んでいるためソート順のリークを防ぐ目的で、レース内の行を馬番順に並び替えてから学習しています。
3. 特徴量
投入した特徴量を大きく4つに分類します。
3-1. 馬自身の情報(今走)
- 馬体重・馬体重増減・生後日数・キャリア(Z正規化も追加)
- 斤量体重比・馬齢斤量差
- 距離・ラウンド
- 充足率(出走頭数 / フルゲート頭数)
- 芝ダート・天気・性別・所属のone-hot
3-2. 生涯累計賞金
馬ごとに、当該レース以前の獲得賞金を累計した値です。強い馬ほど賞金を稼いでいるという情報を反映します。リーク防止のため当該レース分は含めません。
3-3. 騎手・調教師スコア
騎手・調教師それぞれについて、過去50戦の平均ラベル(1着×4、2着×2、3着×1の平均)を計算したものです。さらに、クラスコード(未勝利=7からG1=195まで)と掛け合わせた加重スコアも追加しています。G1で勝った騎手と未勝利戦で勝った騎手の評価を差別化する意図があります。
これも当該レース以前のデータのみで計算しています。
3-4. 前走特徴量(前1〜5走)
前走データは血統登録番号で馬を識別し、日付順にshift(1)〜shift(5)で取得しています。前走ごとに12種類の特徴量を生成しました。
| 特徴量 |
内容 |
| 着差 |
そのままの値 |
| 人気超過率 |
(人気 − 着順) / 頭数。期待を上回ったかの指標 |
| クラス差 |
今走クラスコード − 前走クラスコード |
| 相対順位 |
(頭数+1−着順) / 頭数。1位=1.0、最下位≒0 |
| タイム偏差 |
走破タイム − 基準タイム(秒換算)。コース補正後の速さ |
| 上り3F |
そのままの値 |
| 距離差 |
今走距離 − 前走距離 |
| 間隔 |
前走からの日数 |
| PCI−50 |
PCIから50を引いたもの |
| PCI3−50 |
PCI3から50を引いたもの |
| RPCI−50 |
RPCIから50を引いたもの |
| PCI−RPCI差 |
個馬とレース全体のペース乖離 |
加えて、過去5走の平均距離と今走距離の差(過去5走平均距離差)を別途計算して追加しています。
4. 結果
2024年の検証データ(2,977レース)で評価した疑似R²は以下の通りです。
確定オッズの0.21に対して、ファンダメンタルズ情報だけで0.14という結果です。
Feature importanceのTOP10は以下です。
| 順位 |
特徴量 |
importance |
| 1 |
前1走_タイム偏差 |
18,960 |
| 2 |
前1走_相対順位 |
18,673 |
| 3 |
騎手スコア |
12,395 |
| 4 |
前1走_人気超過率 |
9,372 |
| 5 |
前1走_クラス差 |
4,577 |
| 6 |
騎手加重スコア |
3,747 |
| 7 |
前2走_相対順位 |
3,644 |
| 8 |
前2走_タイム偏差 |
3,348 |
| 9 |
前1走_着差 |
2,244 |
| 10 |
前1走_間隔 |
2,233 |
前走タイム偏差と前走相対順位が1・2位を占めており、「前走でどれだけ速く走ったか」と「前走で頭数の中でどれだけ上位に来たか」が最も予測力の高い情報であることが分かります。騎手スコアが3位に入っているのも、騎手の腕がそれだけ着順に影響していることを示していて興味深いです。
5. 考察
0.14という数字をどう評価するかですが、確定オッズ(0.21)との差0.07が残っている以上、市場にはまだファンダメンタルズで説明できない情報が乗っていることになります。
一方で、市場の情報を一切使わずに0.14を出せているということは、ファンダメンタルズモデルと市場確率を組み合わせることで期待値プラスの馬券を探せる余地があるという示唆でもあります。これはBenterの戦略の核心です。
現状、血統情報や同コース・同距離での過去成績などをまだ特徴量に含んでいないため、さらなる改善の余地はあります。また今回は前走5走分のデータを使いましたが、6〜10走分に広げても精度が上がらないことも確認しており、直近5走が情報の実質的な上限であることが分かりました。
次のステップとしては、ファンダメンタルズモデルの確率と市場確率の乖離からベッティングシステムに繋げることを考えています。
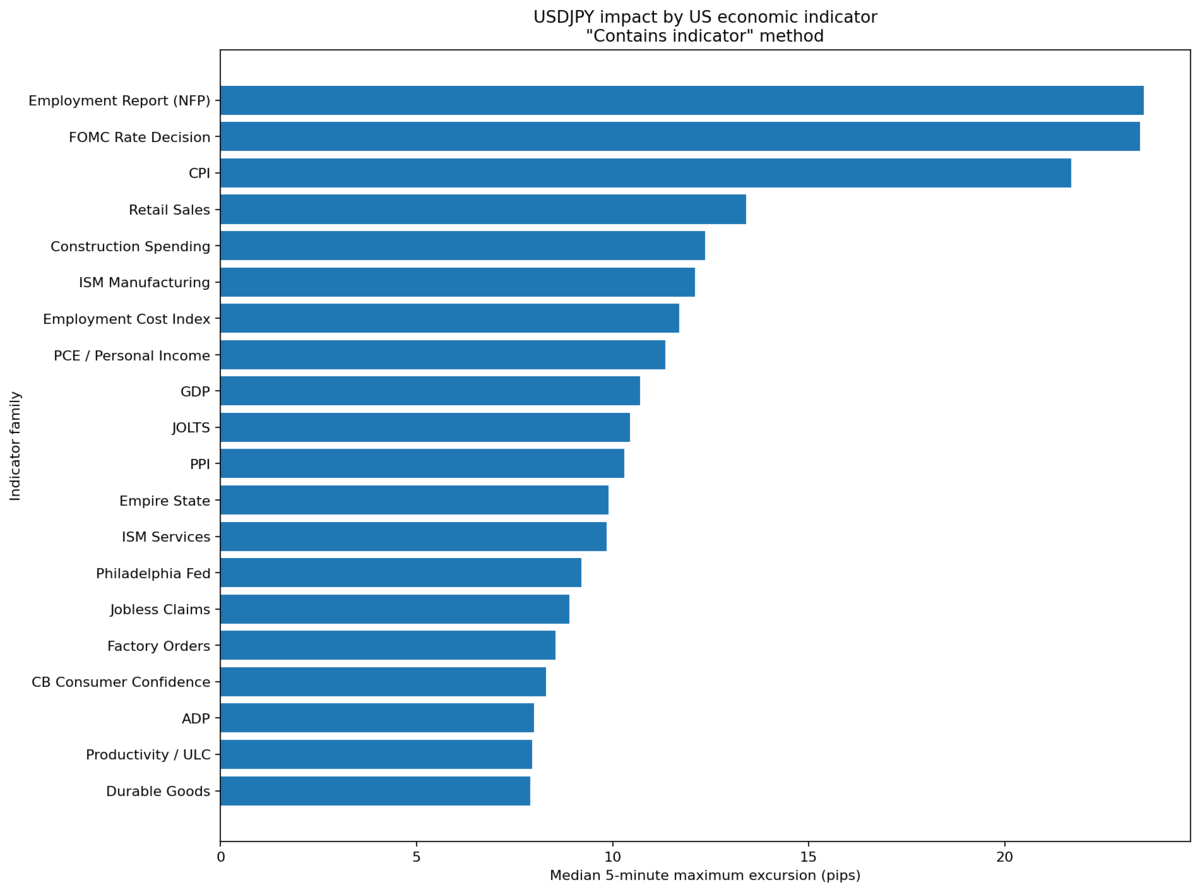
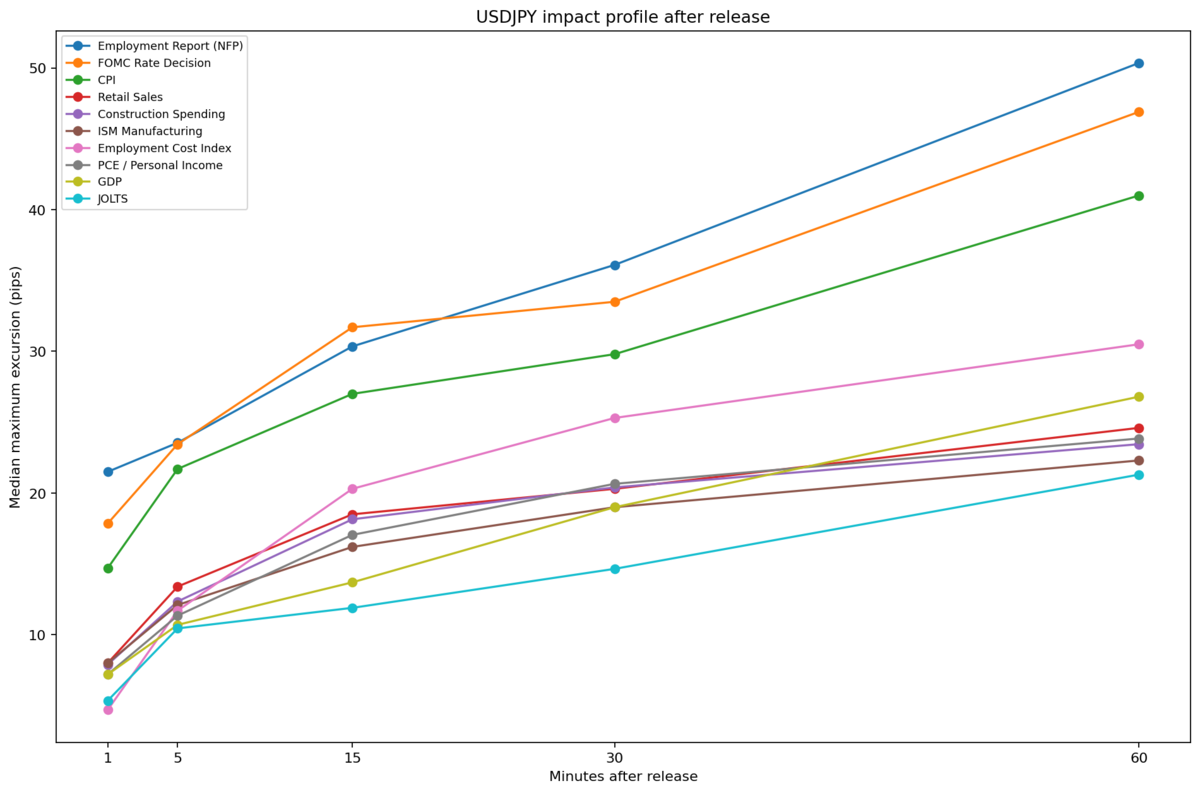
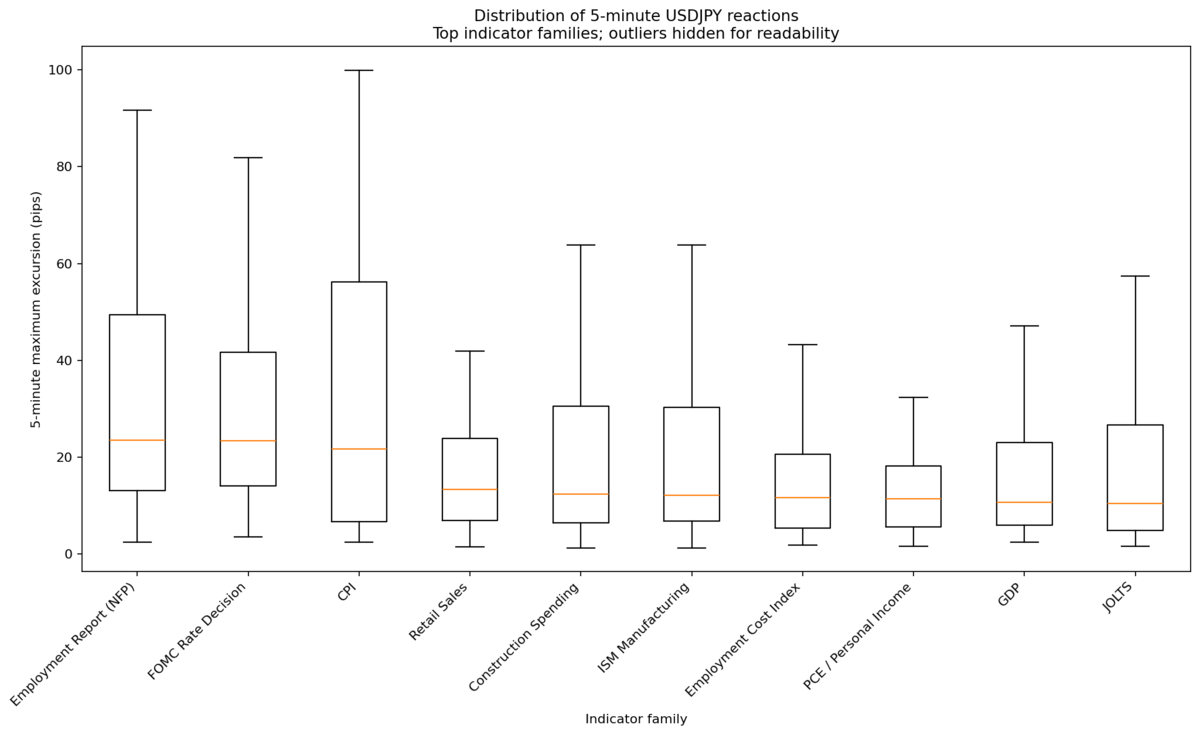
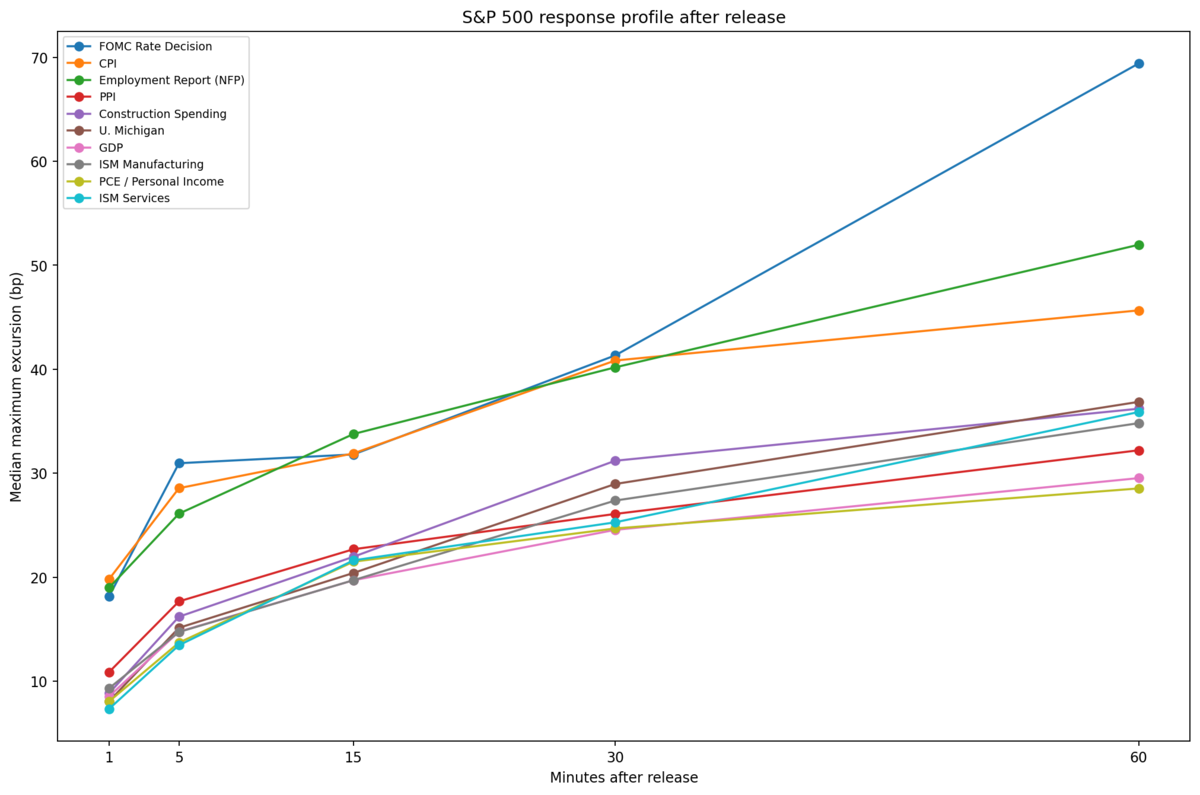
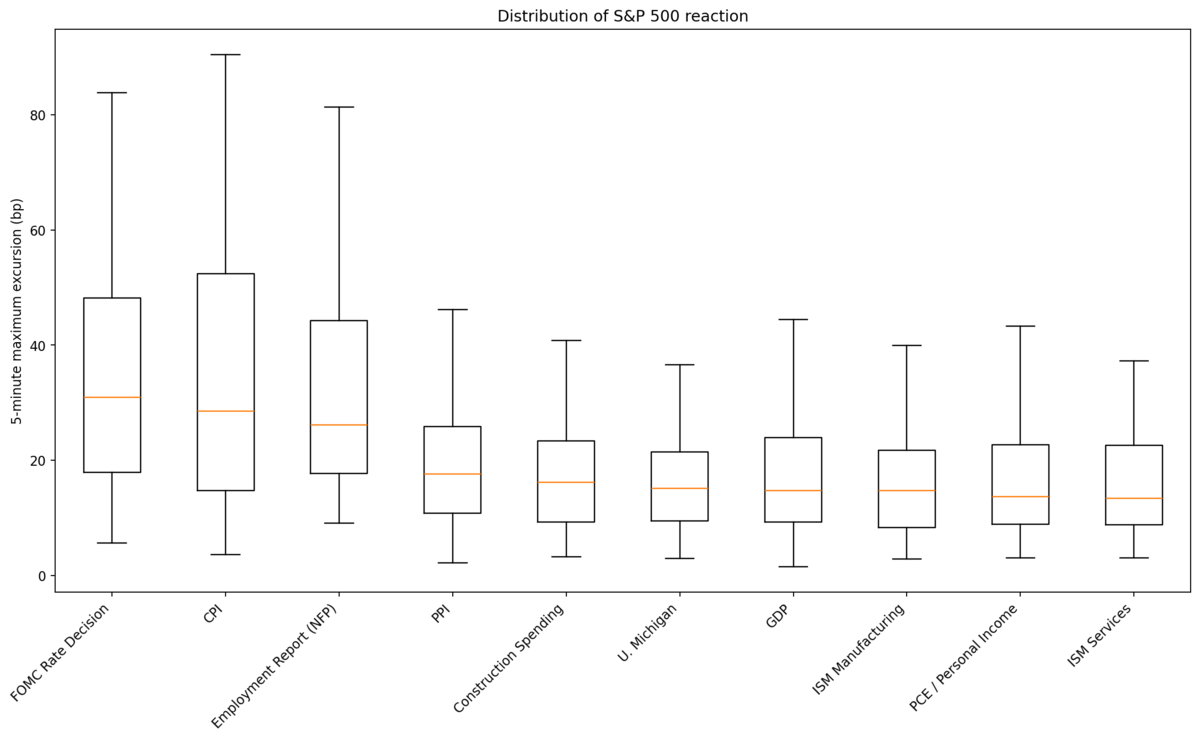
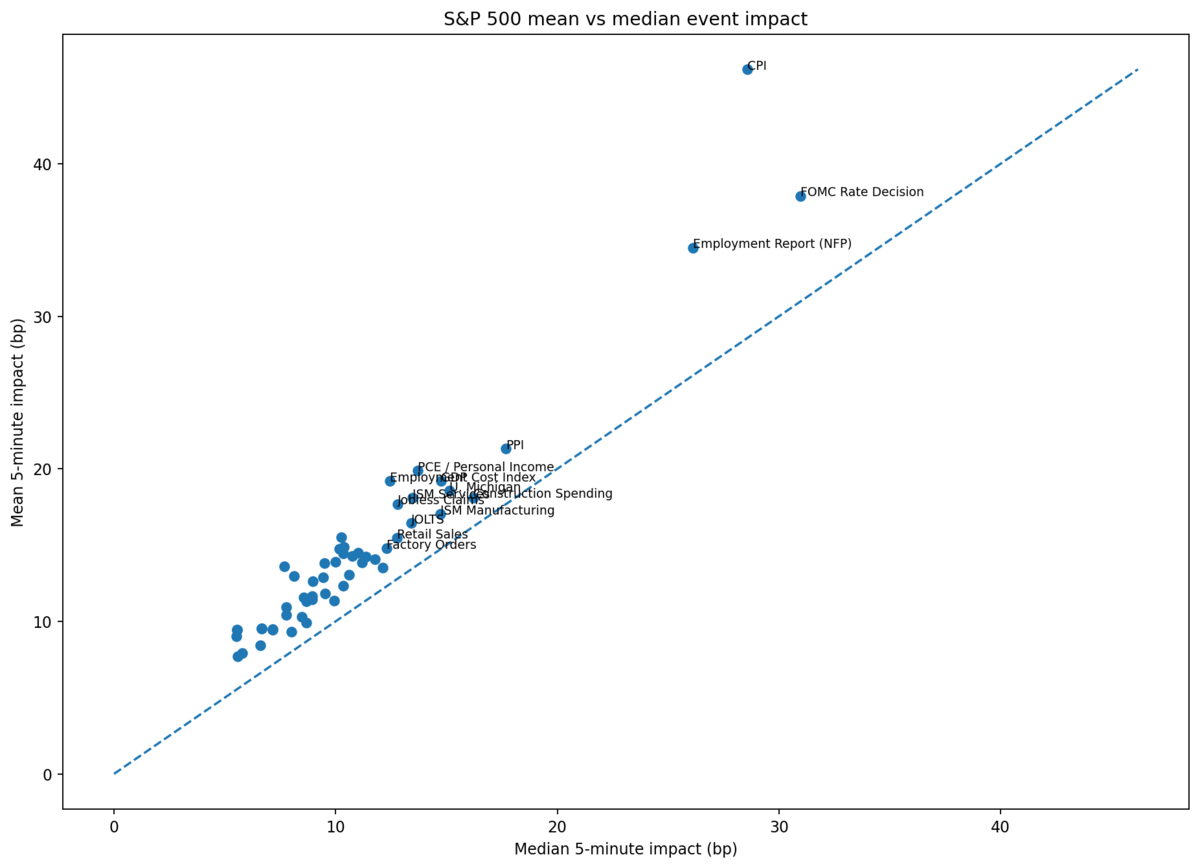
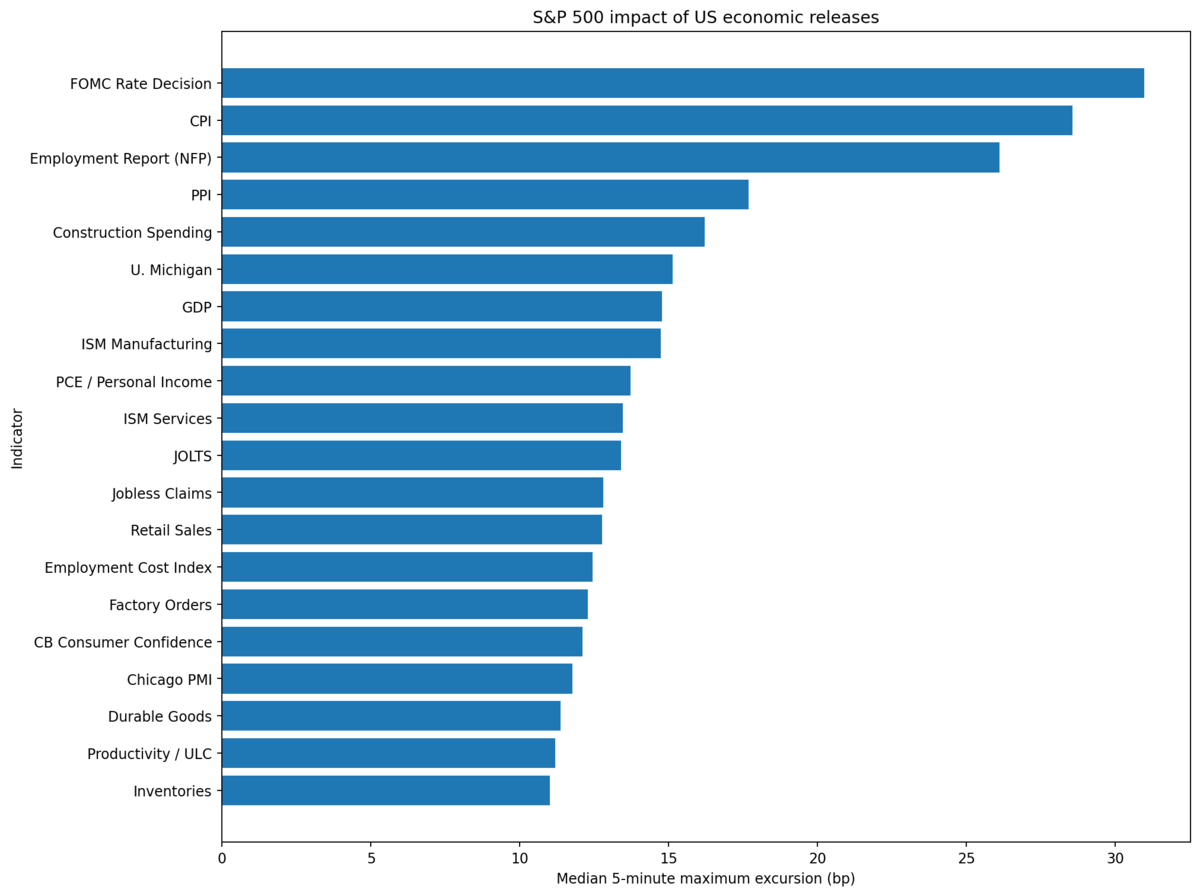 SP500に対して上と同じ分析をしてみた。上位三役は同じだが、織り込み済みのはずのFOMCで一番大きく動いている。続いてCPI、NFPと続く。近しい値なので無理に解釈することもないと思う。